【bash】特殊変数・汎用構文
制御シェルの種類
sourceを用いる方法と直接シェルスクリプトを用いる方法で制御するシェルが異なる。
| 実行方法 | 特徴 |
|---|---|
| source | ログインセッションの一部であるかのように通常シェルで実行される。 |
| sh or スクリプト指定 | シェルスクリプトの中から呼び出されるコマンドはサブシェルとして実行され、完了すると制御を親シェルに戻す。親とサブシェルに別れることで、環境変数を分けるなど有効な使用方法があるらしい。 |
特殊変数
| 変数名 | 内容 |
|---|---|
| $* | 全ての位置パラメータを保持する変数。""で囲んだ場合、全ての位置パラメータの外側を""で括った値になる。 [例]: $ sample.sh s1 s2 ⇨ "s1 s2" |
| $@ | 全ての位置パラメータを保持する変数。""で囲んだ場合、各位置パラメータを""で括った値になる。 [例]: $ sample.sh s1 s2 ⇨ "s1" "s2" |
| $0 | スクリプト名。 |
| $# | 位置パラメータの数。 [例]: sample.sh s1 s2 ⇨ 2 |
| $? | 直前に実行されたコマンドの終了ステータス。正常終了の場合は0、異常終了の場合は0以外(1が警告、2がエラーのことが多い)。 |
| $! | バックグラウンドで実行されたコマンドのプロセスID。 |
| $$ | コマンド自身のPID。 |
汎用構文
| 構文 | 内容 |
|---|---|
| ${} | 変数名を区切るために使用される構文。例えば10番目以降の引数を用いる場合、変数の後ろに文字列を続けたい場合、可読性をあげたい場合に使用される。echo "${10}"echo "${var}_sample" |
| $() | 括弧内のコマンドを実行して結果を返す構文。バッククォート(`)で括るのと結果は同じだが、ネスト可能・可読性高いという理由でこちらの構文を使用する方が好ましい。 |
| $(()) | 括弧内の算術演算を行う構文。 |
文字列演算子の構文
| 構文 | 内容 | 備考 |
|---|---|---|
| ${#var} | 変数の値の長さを文字列で返す。 [例]: var="sample"echo "${#sample}" ⇨ 6が表示される。 |
- |
| ${var:-word} | 変数varが存在し、かつnullでない場合にその値を返す。それ以外の場合はwordを返却する。 [例]: echo ${var:-sample} ⇨ sample |
- |
| ${var:=word} | 変数varが存在し、かつnullでない場合にその値を返す。それ以外の場合、varにwordを代入する。ただし、位置パラメータや特殊パラメータは使用できない。 [例]: echo ${var:=sample} ⇨ sampleが表示されるecho $var ⇨ sampleが表示される。 |
- |
| ${var:?message} | 変数varが存在し、かつnullでない場合にその値を返す。それ以外の場合、messageを出力してコマンドあるいはスクリプトを中止する。 | - |
| ${var:+word} | 変数varが存在し、かつnullでない場合にwordを返す。それ以外の場合、nullを返す。 | - |
| ${var:offset:length} | 変数varの値から、offsetの位置からlength数の長さの部分文字列を取り出す。varが@の場合、offsetを先頭とする位置パラメータの番号となる。 [例]: var="sample"echo "${var:2:2}" ⇨ mpが表示される。 |
- |
| ${var#pattern} | 変数varの値の始めの部分とpatternが一致した場合、最初に一致した部分を削除して残りの値を返す。 [例]: var="/Users/tands_b/sample.tar.gz"echo "${var#/*/}" ⇨ tands_b/sample.tar.gzが表示される。 |
パターンに使用できるワイルドカードは*, ?, [] |
| ${var##pattern} | 変数varの値の始めの部分とpatternが一致した場合、最初からパターンの一致が終わるまでを削除して残りの値を返す。 [例]: var="/Users/tands_b/sample.tar.gz"echo "${var##/*/}" ⇨ sample.tar.gzが表示される。 |
同上 |
| ${var%pattern} | 変数varの値の終わりの部分とpatternが一致した場合、最初にパターンが一致した部分を削除して残りの値を返す。 [例]: var="/Users/tands_b/sample.tar.gz"echo "${var%.*}" ⇨ /Users/tands_b/sample.tarが表示される。 |
同上 |
| ${var%%pattern} | 変数varの値の終わりの部分とpatternが一致した場合、最後からパターンが一致した部分を削除して残りの値を返す。 [例]: var="/Users/tands_b/sample.tar.gz"echo "${var%%.*}" ⇨ /Users/tands_b/sampleが表示される。 |
同上 |
| ${var/pattern/string} | 変数varの値で最初にpatternと一致した部分がstringに置換された値を返す。 [例]: var="/Users/tands_b/sample.tar.gzecho "${var/\/*\//\~/}" ⇨ ~/sample.tar.gzが表示される。 |
同上 |
| ${var//pattern/string} | 変数varの値でpatternと一致した部分が全てstringに置換された値を返す。 | 同上 |
文字列演算子の活用
擬似履歴機能を持ったcdコマンドを実装できる。通常cd, cd - では一回分の移動しか記憶できない。
# cd の代わり。メモリに移動先をスタックする。
function pushd()
{
  local dirname="${1:-${HOME}}"
  if [ ! -e "$dirname" ]; then
    echo "$dirname: No such file or directory"
    return 1
  fi

  if [ "${dirname:0:1}" != "/" ]; then
    dirname="${DIR_STACK%% *}/${dirname}"
  fi

  DIR_STACK="$dirname ${DIR_STACK:-$PWD}"
  cd ${dirname:?"missing directory name."}
}

# cd - の代わり。 メモリにスタックされた階層をポップする。
function popd()
{
  DIR_STACK="${DIR_STACK#* }"
  cd "${DIR_STACK%% *}"
  echo $PWD
}
【bash】設定・組み込み変数
bash設定ファイル
bashにはログイン時やbashシェル実行時に読み込まれる設定ファイルが存在する。いくつか種類や読み込まれる順番があるのでここで見ていく。
| ファイルパス | 概要 |
|---|---|
| /etc/profile | 全ユーザのログイン時に読み込むデフォルトの設定ファイル。 |
| ~/.bash_profile | ログイン時に一番最初に読み込まれるファイル。ログインシェルだけが読み込み、サブシェルは.bashrcから設定を読み込むためログインシェルとサブシェルでコマンドを分けることができる。 |
| ~/.bash_login | Cシェルの.loginに由来する。.bash_profileが存在しない場合に読み込まれる。 |
| ~/.profile | BourneシェルとKornシェルの.profileに由来する。.bash_profileも.bash_loginも存在しない場合に読み込まれる。 |
| ~/.bashrc | bashを実行する際に読み込まれる設定ファイル。 |
組み込み変数
一般的に知られるUNIXの組み込み変数のうち、気になったものをピックアップ。
| 変数名 | 概要 |
|---|---|
| HISTCMD | 現在のコマンドの履歴番号。 |
| HISTFILE | コマンド履歴が保存される履歴ファイル。 |
| HISTFILESIZE | 履歴リストに保存するコマンドラインの最大数。 |
| HISTSIZE | コマンド履歴に保存するコマンドの最大数。 |
| HISTTIMEFORMAT | historyコマンド実行時に表示されるタイムスタンプフォーマット指定。 |
| FCEDIT | fcコマンドで使用するエディタのパス。 |
| PS1 | プライマリプロンプト文と呼ばれるシェルプロンプト。プロンプトの表示名を変更できる。 |
| CDPATH | cdコマンド実行時にサブディレクトリを検索するパス。 カレントディレクトリ以下に移動対象が存在しない場合、CDPATHに設定されたパス以下を探しにいく。 |
| OLDPWD | 最後のcdコマンドが実行される前のディレクトリ。 |
| IFS | 項目の区切り記号で、デフォルトは半角スペース。echo "$*" などで区切りを「,」にしたい場合、IFS=","にすれば変更可能。 |
PS1設定
使いそうなものだけピックアップ。
| コマンド | 概要 |
|---|---|
| \A | 「HH:MM」表記(24時間表記)での現在時刻。 |
| \T | 「HH:MM:SS」表記(12時間表記)での現在時刻。 |
| \t | 「HH:MM:SS」表記(24時間表記)での現在時刻。 |
| \@ | 「午前/午後」付の12時間表記での現在時刻。 |
| \d | 「曜日、月、日」表記での日付。 |
| \e | ASCIIエスケープ記号。 |
| \H | ホスト名。 |
| \h | 最初の.までのホスト名。 |
| \n | 改行。 |
| \s | シェル名。 |
| \u | ユーザ名。 |
| \w | 現在の作業ディレクトリ。 |
| \W | 現在の作業ディレクトリのベース名。 |
| # | 現在のコマンドのコマンド番号。 |
| \$ | 実行ユーザIDが0であれば#、それ以外は$を表示。 |
【Docker】Dockerfile
Dockerfileとは
Dockerfileとは、Dockerコンテナの構成内容を記述したテキスト形式のファイルのこと。Dockerfileを用いてDockerコンテナを生成することができる。
Dockerfileに記述できる命令
| 命令 | 概要 |
|---|---|
| ADD | ビルドコンテキストあるいはリモートURLからイメージへファイルをコピーする。 |
| CMD | コンテナ起動後に記述された命令を実行する。ENTRYPOINTが定義されている場合、CMDはENTRYPOINTへの引数として解釈される。また、最後に記述されたCMDのみ実行される。CMD ["コマンド", "パラメータ"] |
| COPY | ビルドコンテキストからイメージにファイルをコピーする。COPY src destCOPY ["src", "dest"] |
| ENTRYPOINT | コンテナ起動時に実行される実行可能ファイルを設定する。 |
| ENV | イメージ内の環境変数の設定。 |
| EXPOSE | プロセスが指定されたポートで待受を行うことを指定する。 |
| FROM | ベースイメージを設定する。この命令を記述する場合、Dockerfileの最初の命令として記述する必要がある。FROM イメージ:タグ |
| MAINTAINER | イメージのAuthorデータを指定された文字列に設定する。内容は以下コマンドで取得できる。docker inspect -f {{.Author}} イメージ |
| ONBUILD | 他のイメージからベースイメージとして使用された場合に実行する命令を記述する。 |
| RUN | 指定された命令をコンテナ内で実行し、結果をコミットする。 |
| USER | USER以降のRUN, CMD, ENTRYPOINT命令で使用されるユーザを設定する。 |
| VOLUME | 指定されたファイルもしくはディレクトリがボリュームであることを宣言する。 |
| WORKDIR | これ以降のRUN, CMD, ENTRYPOINT, ADD, COPY命令で使用される作業ディレクトリを設定する。 |
【Docker】dockerコマンド基礎
前置き
基本的なコマンド一覧を載せています。全てのコマンドを載せているわけではないので詳しくはhelpで確認してみてください。
docker --help
コンテナ操作・管理
Dockerコンテナの管理や操作を行うコマンド群。docker <コマンド>で実行する形になる。
| コマンド | 概要 |
|---|---|
| run | 新規コンテナを起動する。 |
| create | イメージからコンテナ作成を行う。但しrunと異なりコンテナの起動は行わない。 |
| start | 停止しているコンテナを起動する。 |
| stop | 起動しているコンテナを停止する。-tオプションでプロセスがkillされるまでの待機時間を設定できる。 |
| restart | コンテナを再起動する。-tオプションでプロセスがkillされるまでの待機時間を設定できる。 |
| pause | 指定されたコンテナ内の全プロセスをサスペンドする。 内部的にはLinuxのcgroupsのfreezer機能を使用している。 |
| unpause | pauseしているコンテナの全プロセスを動かす。 |
| attach | 指定したコンテナの標準入力、標準出力、エラー出力をローカルのターミナルに表示することができる。 |
| cp | コンテナ・ホスト間でファイルやディレクトリのコピーを行う。 |
| exec | 起動中のコンテナでコマンドを実行する。sshの代わりとして使用できる。docker exec <コンテナID> echo "Hello" |
| kill | 起動中コンテナのメインプロセスを停止させる。 |
| rm | コンテナを削除する。 |
| diff | 現在のコンテナの状態と起動元イメージのファイルシステム差分を表示する。 |
| events | Dockerデーモンのリアルタイムイベントを出力する。 |
| inspect | 指定されたコンテナ・イメージの詳細情報を表示する。 |
| logs | コンテナのSTDERRやSTDOUTに書き出された内容(ログ)を表示する。 |
| port | 指定されたコンテナの公開ポートのマッピングリストを表示する。 |
| ps | 現在のコンテナ群に関す情報を表示する。 |
| top | 指定されたコンテナ内で実行中のプロセス情報を表示する。 |
runコマンド
runコマンドによって新規コンテナを起動することができる。使用されることの多いオプションは以下の通り。
| コマンド | オプション | 概要 |
|---|---|---|
| run | -a | 指定されたストリーム(stdout, stderrなど)をターミナルにアタッチする。 |
| -d | コンテナをバックグラウンドで実行する。 | |
| -i | stdinをオープンにしたままに保ち、-tと一緒に使われることが多い。 | |
| -t | 擬似的なTTY(端末デバイスの名前)を割り当てる。 -i と併用することでsshで接続したかのように操作することができる。 |
|
| --restart | コンテナの再起動設定を行う。noを指定するとリスタートなし、 alwaysは終了ステータスに関わらず再起動、 on-failureは0以外のステータスで終了した場合に再起動。 リトライ回数も指定できる。 |
|
| --rm | 終了時にコンテナを自動的に削除する。-dとの併用不可。 | |
| -e | コンテナ内の環境変数を設定する。docker run -e <変数>=<値> debian |
|
| --env-file | ファイルから変数を渡せる。 | |
| -h | Unixホスト名を設定する。 | |
| --name | 名前をコンテナに割り当てる。 | |
| -v | ホスト側のディレクトリをコンテナ内にマウントすることができる。docker run -v <ホスト側のパス>:<コンテナ側のパス> debian |
|
| --volumes-from | 指定したコンテナからボリュームをマウントする。docker run --volumes-from <コンテナ名> debian |
|
| --expose | コンテナで使用されるポートを指定する。但しオープンする場合は-pオプションと一緒に使用する。 | |
| --link | 指定されたコンテナに対するプライベートなNetworkInterfaceをセットアップする。 | |
| -p | コンテナのポートを公開する。ホストからアクセス可能になる。ホストのポートが指定されていない場合は大きいポート番号がランダムに使用される。 | |
| --entrypoint | コンテナのENTRYPOINTを設定する。DockerfileないのENTRYPOINT命令は全て上書きされる。 | |
| -u | コマンドを実行するユーザを設定るす。 | |
| -w | コンテナ中の作業ディレクトリを設定する。 |
rmコマンド
コンテナを削除するコマンド。デフォルトではボリュームを削除しない。よく使用するオプションは以下の通り。
| コマンド | オプション | 概要 |
|---|---|---|
| rm | -f | 実行中のコンテナを削除する。 |
| -v | 削除するコンテナが作成したボリュームも削除する。 |
[TIPS]
# 全コンテナ削除
docker rm $(docker ps -aq)
cpコマンド
# ローカルファイルをコンテナにコピー
docker cp <ローカルファイルパス> <コンテナID>:<ファイルパス>

# コンテナファイルをローカルにコピー
docker cp <コンテナID>:<ファイルパス> <ローカルファイルパス>
イメージ管理・操作
Dockerイメージを扱うコマンド群を紹介します。
| コマンド | 概要 |
|---|---|
| images | ローカルのイメージリストを表示する。-qオプションを使用することでIDのみ表示させられる。 |
| history | イメージの各例やの情報を表示する。 |
| build | Dockerfileからイメージを構築する。 |
| commit | 指定されたコンテナからイメージを生成する。一般的には再現しやすいDockerfileから構築する方が汎用性が高い。 |
| export | コンテナのファイルシステム内容をtarファイルとしてSTDOUTに出力する。ポートなどのメタデータやボリュームは出力されない。 |
| import | ファイルシステムを含むアーカイブからイメージを生成する。ポートなどのメタデータは読み込まれない。 |
| save | イメージもしくはリポジトリをtarアーカイブにしてSTDOUTにストリーム出力する。メタデータを保持させることが可能。 |
| load | STDIN経由で渡されたtarアーカイブからリポジトリを生成する。このイメージには履歴とメタデータが含まれ、saveコマンドによって生成されたアーカイブを利用する。 |
| rmi | 指定されたイメージを削除する。タグ名が指定されていない場合はlatestが削除される。また、rimコマンドはリポジトリごとに実行する必要がある。 |
| tag | イメージにリポジトリとタグ名を関連づける。 |
tagコマンド
イメージにリポジトリとタグ名を関連づけるコマンド。具体的な使用例は以下の通り。
# リポジトリにイメージを追加。タグはlatestになる。
$ docker tag <イメージID> <リポジトリ名>

# タグを設定してリポジトリにイメージを追加。
$ docker tag <イメージ名>:<ローカルタグ名> <リポジトリ名>:<タグ名>
レジストリ利用
Docker Hubを含むレジストリを利用するためのコマンド群を紹介します。
| コマンド | 概要 |
|---|---|
| login | 指定されたレジストリサーバへ登録やログインを行う。サーバの指定がない場合はDocker Hubが使用される。 |
| logout | レジストリからログアウトする。 |
| pull | 指定されたイメージをレジストリからダウンロードする。タグが指定されなかった場合はlatestタグ(公式またはそれに準じたもの)のついたイメージがダウンロードされる。docker pull <イメージ名>:<タグ名>docker pull <ホスト名>:<ポート番号>/<リポジトリパス>:<タグ> |
| push | イメージもしくはリポジトリをレジストリにアップロードする。タグ指定がない場合はリポジトリ内の全イメージがアップロードされる。 |
| search | 検索条件にマッチしたDocker Hub上の公開リポジトリのリストを最大25個表示する。 |
Docker全般
インストールされたDockerに関する情報表示コマンドを紹介します。
| コマンド | 概要 |
|---|---|
| info | Dockerのシステム及びホスト情報を表示する。 |
| version | Dockerクライアント及びサーバ、コンパイルに使用されたGoのバージョンを表示する。 |
【Mac】設定メモ
sudo でパスワードの入力を無くす方法
visudo コマンドでsudo設定ファイルを以下の通りに編集する。
【編集前】
$ sudo visudo

# root and users in group wheel can run anything on any machine as any user
root       ALL = (ALL) ALL
%admin ALL = (ALL) ALL
【編集後】
$ sudo visudo

# root and users in group wheel can run anything on any machine as any user
root       ALL = (ALL) ALL
%admin ALL = (ALL) ALL
<ユーザ名> ALL = (ALL) NOPASSWD:ALL
【SQL】アンチパターン
目次
前置き
この記事のSQLはMySQLで書かれています。
また、全てオライリー SQLアンチパターンから学びのあったものだけ引用しています。
ジェイウォーク
概要
カンマ区切りフォーマットなどのリストデータを格納すること。
INSERT INTO customer (customer_id, item_id) ('xxxx', 'a,b,c,d');
問題点
- リストの長さに制限がある。
- データ型が文字列型になるため、誤ったデータが入る可能性がある。
- 検索が行いにくい
- etc
解決策
交差テーブルを作成する。一つのカラムに複数の値をいれないことで、テーブル結合や検索が容易になる。
CREATE TABLE contacts (
    customer_id BIGINT NOT NULL,
    item_id BIGINT NOT NULL,
    PRIMARY KEY (customer_id, item_id),
    FOREIGN KEY (customer_id) customer(customer_id),
    FOREIGN KEY (item_id) item(item_id)
);
ナイーブツリー
概要
コメントの親子関係把握の場合などデータが階層構造になる場合に、テーブル内に親子情報を持たせること。ただし、再帰クエリをサポート指定いるRDBの場合はアンチパターンの対象ではない。
CREATE TABLE comments(
    comment_id SERIAL PRIMARY KEY,
    parent_id BIGINT UNSIGNED,  # 親のcomment_idが入る。
    FOREIGN KEY (parent_id) REFERENCES comments(comment_id)
);
問題点
解決策
RDBMSが再帰クエリをサポートしていない場合、わかりやすさを考慮して親子関係を保持するテーブルを用意するのが良い。ただしデータ量が増えてしまうためトレードオフにはなる。
CREATE TABLE paths (
    parent_id BIGINT UNSIGNED NOT NULL,
    child_id BIGINT UNSIGNED NOT NULL,
    PRIMARY KEY (parent_id, child_id),
    FOREIGN KEY (parent_id) REFERENCES comments(comment_id),
    FOREIGN KEY (child_id) REFERENCES comments(comment_id)
);
EAV(エンティティ・アトリビュート・バリュー)
概要
あるKeyに対するValueを保持させたい場合、楽な設計方法として汎用的な属性テーブルを使用してしまうこと。
CREATE TABLE target (
    target_id SERIAL PRIMARY KEY,
);
INSERT INTO target (target_id) VALUES (100);

CREATE TABLE target_attribute (
    target_id BIGINT UNSIGNED NOT NULL,
    attr_name VARCHAR(20) NOT NULL,
    attr_value VARCHAR(20) NOT NULL,
    PRIMARY KEY (target_id, attr_name),
    FOREIGN KEY (target_id) PREFERENCES target(target_id)
);
INSERT INTO target_attribute (target_id, attr_name, attr_value)
    VALUES
        (100, 'attr1', '1')
        (100, 'attr2' '2017');
問題点
- SQLのデータ型を使用できないため、フォーマットのチェックが必要になる。
- 必須な属性を設定することができない。
- 参照整合性を強制できない。
解決策
シングルテーブル継承
attributeを全て一つのテーブルのカラムとして管理する。
CREATE TABLE target (
    target_id SERIAL,
    attr1 VARCHAR(20) NOT NULL,
    attr2 VARCHAR(20)
    PRIMARY KEY (target_id, attr1)
);
具象テーブル継承
サブタイプごとにテーブルを作成する。
CREATE TABLE target_attr1 (
    target_id SERIAL,
    value VARCHAR(20) NOT NULL,
    PRIMARY KEY (target_id, value)


CREATE TABLE target_attr2 (
    target_id SERIAL,
    value VARCHAR(20) NOT NULL,
    PRIMARY KEY (target_id, value)
);
ポリモーフィック関連
概要
異なる属性やテーブルに対する共通的なカラムを準備すること。例えば、commentsテーブルの中にコメント種別を格納するcomment_typeカラムを用意し、"sports_news" や "economic_news"など属性を判断できるようなデータを入れること。ただし、ORMを利用する場合は親テーブルの作成に影響を受けないようにするため、ポリモーフィック関連をあえて使用する場合がある。
CREATE TABLE comments(
    comment_id SERIAL PRIMARY KEY,
    comment_content TEXT,
    news_type VARCHAR(20) NOT NULL,
    news_id BIGINT UNSIGNED NOT NULL
);

INSERT INTO comments (comment_id, comment_content, news_type, news_id)
    VALUES
        (100, 'comment1', 'sports', 2000);

INSERT INTO comments (comment_id, comment_content, news_type, news_id)
    VALUES
        (101, 'comment2', 'economic', 3000);
問題点
- 他テーブルを柔軟に参照できる一方、news_idなどに参照制約をかけることができない。
解決策
参照を逆にする。
共通的なカラムを用意せず、各親テーブルに参照カラムを追加する。
CREATE TABLE comments(
    comment_id SERIAL PRIMARY KEY,
    content TEXT
);

CREATE TABLE economic_news(
    news_id SERIAL PRIMARY KEY,
    sentence TEXT,
    comment_id VARCHAR(20) NOT NULL,
    FOREIGN KEY (comment_id) REFERENCES comments(comment_id)
);

CREATE TABLE sports_news(
    news_id SERIAL PRIMARY KEY,
    sentence TEXT,
    comment_id VARCHAR(20) NOT NULL,
    FOREIGN KEY (comment_id) REFERENCES comments(comment_id)
);
交差テーブルの作成
中間テーブルを作成し、接続したいテーブルを外部参照させる。検索条件を柔軟に変更できるがテーブル数が増えてしまう。
CREATE TABLE economic_news (
    news_id SERIAL PRIMARY KEY,
    sentence TEXT
);
CREATE TABLE economic_news_comments (
    news_id SERIAL PRIMARY KEY,
    comment_id VARCHAR(20) NOT NULL,
    FOREIGN KEY (news_id) REFERENCES economic_news(news_id),
    FOREIGN KEY (comment_id) REFERENCES comments(comment_id)
);

CREATE TABLE sports_news (
    news_id SERIAL PRIMARY KEY,
    sentence TEXT
);
CREATE TABLE sports_news_comments (
    news_id SERIAL PRIMARY KEY,
    comment_id VARCHAR(20) NOT NULL,
    FOREIGN KEY (news_id) REFERENCES sports_news(news_id),
    FOREIGN KEY (comment_id) REFERENCES comments(comment_id)
);
共通的な親テーブルの作成
中間テーブルとして全ての親となるテーブルを作成する。
CREATE TABLE news (
    news_id SERIAL PRIMARY KEY
);

CREATE TABLE economic_news (
    news_id BIGINT UNSIGNED,
    FOREIGN KEY (news_id) REFERENCES news(news_id)
);

CREATE TABLE sports_news (
    news_id BIGINT UNSIGNED,
    FOREIGN KEY (news_id) REFERENCES news(news_id)
);

CREATE TABLE comments (
    news_id BIGINT UNSIGNED,
    content TEXT,
    FOREIGN KEY (news_id) REFERENCES news(news_id)
);
丸め誤差
概要
カラムにFLOAT, REAL, DOUBLE, PRECISION などの小数点数値を扱うデータ型を設定すること。SQLは実数を2進数形式でエンコードするため、10進数から2進数に変換したとき無限小数となるデータは丸め誤差が発生してしまう。
問題点
- FLOAT型のデータをSELECTして乗算した際など、数値に誤差が発生してしまう。
解決策
NUMERICまたはDECIMALデータ型を用いて桁数を指定しておく。
CREATE TABLE comment_rate (
    news_id BIGINT,
    rate DECIMAL(5,2),
    FOREIGN KEY (news_id) references news(news_id)
);

INSERT INTO comment_rate
    VALUES
        (11, 123.45);
31フレーバー
概要
データの値を限定したいとき、列定義で指定すること。例えばCHECK制約やENUM型を用いるなど。
# CHECK制約を用いたパターン
CREATE TABLE news (
    news_id BIGINT,
    news_type VARCHAR(20) CHECK (news_type IN ('sports', 'economic'))
);

# ENUM型を用いたパターン
CREATE TABLE news (
    news_id BIGINT,
    news_type ENUM ('sports', 'economic'),
    PRIMARY KEY (news_id)
);
問題点
- どのような値が入るのか列定義から確認しなくてはいけない(SELECT文で確認できない)
- 設定する値を殖やす場合、列定義を更新する必要があり拡張しづらい
- RDB移植の際にCHECKやENUMを使用していると製品間の仕様差異に引っかかる
解決策
限定する値をデータ(マスターテーブル)で指定する。例では外部参照させることで値を限定させると同時に、値の種別追加などがINSERT文のみで実現可能になっている。
CREATE TABLE news_type (
    news_type VARCHAR(20),
    PRIMARY KEY (news_type)
);

INSERT INTO news_type VALUES ('sports');
INSERT INTO news_type VALUES ('economic');

CREATE TABLE news (
    news_id BIGINT,
    news_type VARCHAR(20),
    PRIMARY KEY (news_id),
    FOREIGN KEY (news_type) REFERENCES news_type(news_type)
);

# 成功
INSERT INTO news VALUES (1, 'sports');

# エラー
INSERT INTO news VALUES (1, 'not_exist');
ファントムファイル
概要
画像データなどバイナリファイルのデータをDBで取り扱う際、データベース内にbyte列として管理せずに物理ファイルとして管理すること。(MySQLではBLOB型として画像データをDB内に保存することができる。)
CREATE TABLE screenshots (
    image_id BIGINT,
    image_path TEXT,
    PRIMARY KEY (image_id)
);
問題点
- データと実体の削除タイミングが異なるため、不整合が発生する可能性がある (トランザクション分離の問題)
- ファイル削除をアプリケーション側で作りこむ必要がある
例外
以下のような場合には物理ファイルを用意した方が適している。
- データベース容量を減らしたいとき
- バックアップ容量削減やバックアップ実行時間を短縮したいとき
解決策
画像ファイルをDBでのみ管理する。この項目に関してはトレードオフが発生するため状況に応じて判断すること。
CREATE TABLE screenshots (
    image_id BIGINT,
    image BLOB,
    PRIMARY KEY (image_id)
スパゲッティクエリ
概要
複雑な問題を一つのSQLで解決しようとして、読みづらいSQLを作成すること。例えばいくつものテーブルをJOINするなど。
解決策
- SQLを分ける。
- UNIONを用いる。
- CASE式とSUM関数を組み合わせる。
【MapReduce】基礎
MapReduce概要
MapReduceとは並列分散処理フレームワークの一つである。分散処理は大きく2つのフェーズに別れており、入力データからKeyとValueのペアを生成するMapフェーズ、Keyに対して条件を指定してValueを絞り込んで抽出するReduceフェーズが存在する。Map処理とReduce処理はコーディングする必要がある。
MapReduce処理フロー
| # | フェーズ | 処理概要 | 出力例 (最も遅い月を抽出) |
|---|---|---|---|
| 1 | 入力 | テキストファイルなどからデータをインプットする。 | 2017,10,... / 2017,12,... |
| 2 | map | インプットされたデータからKeyとValueのペアを生成する。 | (2017, 10) / (2017, 12) |
| 3 | シャッフル | 同一Keyを持つペアを一纏めにする。 | (2017, [10,12]) |
| 4 | Reduce | 指定した条件でValueを抽出する。 | (2017,12) |
| 5 | 出力 | MapReduce処理の結果を出力する。 | 2017, 12 |
MapReduceデータフロー
ジョブとタスク
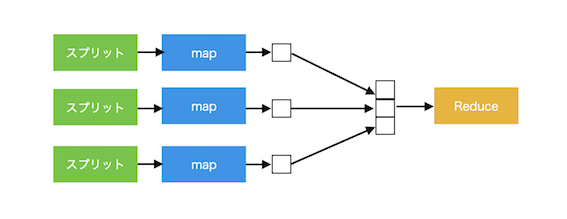
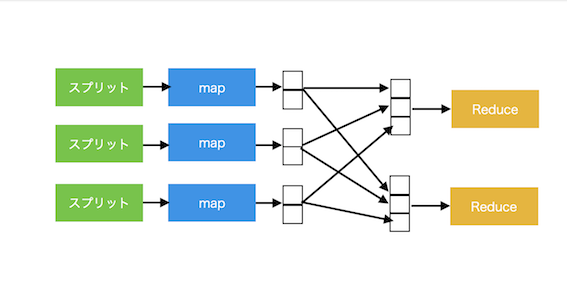
MapReduceの処理全体のことをジョブという。ジョブは2つのタスクから構成されており、mapタスクとreduceタスクが存在する。mapタスクとreduceタスクは 1..n : 1 の関係になっているが、reducerを複数用意することは可能。reducerが複数存在する場合、mapタスクの出力はパーティション化される。
■ reducerが単一のデータフロー図
■ reducerが複数のデータフロー図
スプリット
MapReduceの入力はスプリットに分割され、各スプリットごとにmapタスクが生成される。スプリットという粒度の細かい単位に分割することで、稼働マシンの性能に合わせたロードバランスが行いやすくなる。ただし、粒度を細かくしすぎるとタスク生成のオーバヘッドがかかり過ぎてしまうため注意が必要。
ジョブプロセス制御
MapReduceのジョブプロセスを制御するノードには2種類存在し、1つだけ存在するjobtrackerと、複数存在するtasktrackerがある。tasktrackerはタスクを実行して進捗をjobtrackerに知らせており、jobtrackerは進捗を元にタスクの振り分けなどtasktrackerの管理を行なっている。
集約関数
mapとreduce間の通信データ量を減らして最適化するために、mapの出力に対して集約関数を適用することができる。例えば最も数の大きい値を出力したい場合、mapの結果に対してSUM関数のような処理を指定してやることで、各mapタスクからのデータ量を削減することが可能になる。
Javaを用いた開発
事前準備
Mavenを使用する方法もあるようだが、今回はHadoopライブラリを使用する(Mavenは勉強不足)。Maven Repositoyから「Apache Hadoop Common」と「Hadoop Core」ライブラリをダウンロードし、プロジェクトのビルドパスに追加する。
ダウンロードURL
https://mvnrepository.com/artifact/org.apache.hadoop
Map処理
データ(2017,10,...)をインプットした際に年をKey、月をValueとしたペアを作成するMap処理。
import java.io.IOException;
import java.util.Arrays;
import java.util.List;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

public class MapSample extends Mapper<LongWritable, Text, Text, IntWritable>{

    @Override
    public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
        String line = value.toString();
        List<String> values = Arrays.asList(line.split(","));
        if (values.size() < 2) {
            throw new IllegalArgumentException("The number of value is less than 2.");
        }

        String year = values.get(0);
        int month = 0;
        if (  values.get(1) != null && !values.get(1).isEmpty()) {
            month = Integer.valueOf(values.get(1));
        }

        if (year != null && !year.isEmpty() && month >= 1 && month <= 12) {
            context.write(new Text(year), new IntWritable(month));
        }
    }

}
Reduce処理
シャッフル処理でKeyごとに配列としてまとめられたValueから、最も数の大きい月を抽出するReduce処理。
import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

public class ReduceSample extends Reducer<Text, IntWritable, Text, IntWritable> {

    @Override
    public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
        int maxMonth = 0;
        for (IntWritable value : values) {
            maxMonth = Math.max(maxMonth, value.get());
        }

        context.write(key, new IntWritable(maxMonth));
    }

}
Job実行処理
各フェーズを管理するJobクラスを用いてMapReduceを実行するJob実行処理。
import java.io.IOException;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import com.sun.xml.internal.ws.policy.privateutil.PolicyUtils.Text;
import com.tands.mapreduce.MapSample;
import com.tands.mapreduce.ReduceSample;

public class JobRunner {

    private static final String JOB_NAME = "MapReduce Sample";

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        if (args.length < 2) {
            throw new IllegalArgumentException("Please enter input path and output path.");
        }

        String inputPath = args[0];
        String outputPath = args[1];

        Job job = createJob(inputPath, outputPath);

        // Job実行。引数はverbose設定の有無
        boolean success = job.waitForCompletion(false);
        if (success) {
            System.out.println("Job Success!");
        } else {
            System.out.println("Job Failed");
        }
    }

    private static Job createJob(String inputPath, String outputPath) throws IOException {
        Job job = new Job();

        // Hadoopクラスタを使用してジョブを実行する場合、コードをJARファイルにパッケージ化する
        // setJarByClass()を使用することで、Hadoopがクラスの含まれたJARを見つけ出してくれる
        job.setJarByClass(JobRunner.class);
        job.setJobName(JobRunner.JOB_NAME);

        // データの入出力パスを設定する
        FileInputFormat.setInputPaths(job, new Path(inputPath));
        FileOutputFormat.setOutputPath(job, new Path(outputPath));

        // Map, Reduceクラスを設定する
        job.setMapperClass(MapSample.class);
        job.setReducerClass(ReduceSample.class);

        // OutputのKey, Valueの型を指定
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);

        return job;
    }

}
集約関数の指定
mapの出力結果に対して集約関数を適用したい場合、Job作成時にセットする必要がある。
       // 集約関数としてReducerクラスをセットする
        job.setCombinerClass(ReduceSample.class);
作成モジュールの実行
Hadoopをインストールし、作成したJavaプロジェクトをJARファイル化しておく。以下のコマンドを用いてMapReduce Jobを実行する。
$ hadoop jar <JARファイル> <パッケージ名>.<クラス名> <inputパス> <outputパス>
